

新人が入ってきたら、まずテスト仕様書を渡して「この手順どおりに画面を操作して、合格か不合格かを報告して」とお願いすることは多いかと思います。今回試したのは、その「新人テスター」の役をAIに任せられるか、でした。
これまでも、AIにコードを読んでもらい、バグがないかチェックしてもらうことはありました。今回はそこから一歩進めて、テスト仕様書を渡し、実際に画面を操作してPass/Failまで確認してもらえるかを確かめています。
先に結論を言うと――入力・クリック・結果の確認といった定型作業は、かなり任せられました。「保存しました」と表示されたのに実は保存できていない、そんな「画面の嘘」まで見抜いて報告してきた場面もあります。一方で、何をテストすべきかの設計と、際どいケースの最終確認は、まだ人の仕事でした。どこまで任せられ、どこからは人が要るのか。その線引きを探った記録です。
実施のきっかけの一つが、GPT-6 Astraでした。画面操作の能力が進歩したという情報に触れ、「PCの操作も人間並みにできるのであれば、人が実行していたテストの一部を任せられるのではないか」と感じました。
OpenAIの公式資料でも、GPT-6 AstraはComputer Useやブラウジングで高い性能を持ち、コード・ブラウザ・業務ソフトウェアをまたぐ複数段階の処理を得意とすると説明されています。ただし、ここで抱いた「人間並みなら」という期待と、あらゆる画面操作で人間と同等だと実証されていることは区別します。今回確認した公式資料からは、後者まで断定していません。
知りたかったのは、こうした進歩が実際のソフトウェア開発でどこまで役立つかです。AIに何を任せられて、どこからは人の判断や支援が必要になるのでしょうか。その線引きを考える基礎を作るため、実験用のWebアプリを用意し、Computer Useによるテストに取り組みました。
人による正式なテストの前に、AIが一次テストを担う
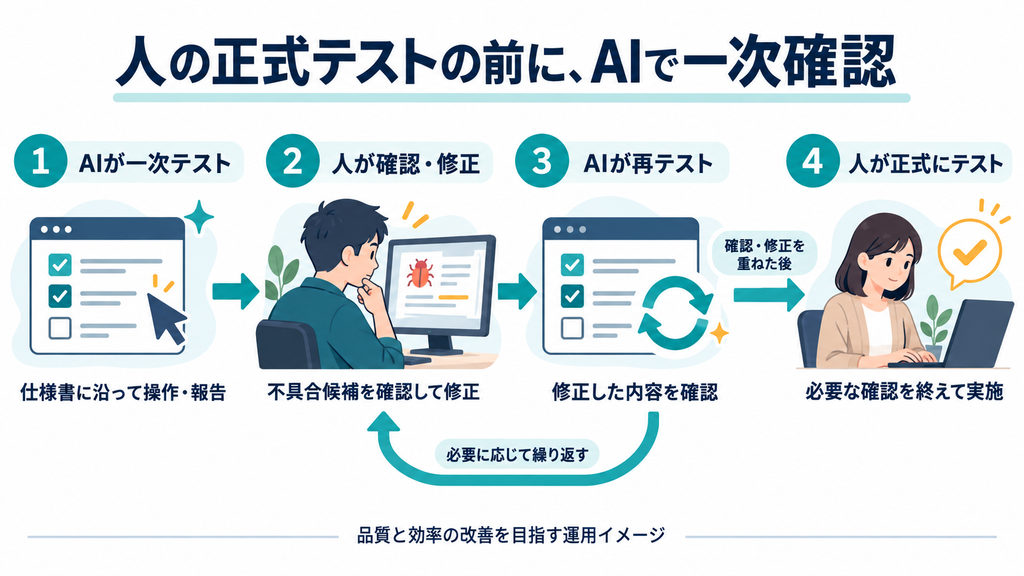
今回思い描いたのは、人が正式にテストを始める「前」に、AIに一次テスト(下見役のような先行チェック)を実行してもらう形です。
流れはこうです。テスト仕様書に沿ってAIが実際に操作し、怪しい動きや不具合の候補を報告する。それを人が確認し、本当にバグであれば修正する。修正した内容をAIに再確認してもらい、この過程を何度か繰り返したうえで、人が改めて正式にテストします。
人がテストを始める前に、見つけられる不具合をある程度減らしておければ、確認や調査に時間を使いやすくなるのではないでしょうか。品質と効率の両方を改善できるかもしれないと考えました。
この段階では、あくまで仮説です。効果を断定するためではなく、実際にどこまで成立するかを確かめるために検証を始めました。
なぜComputer Useの検証に、ソフトウェアテストを選んだのか
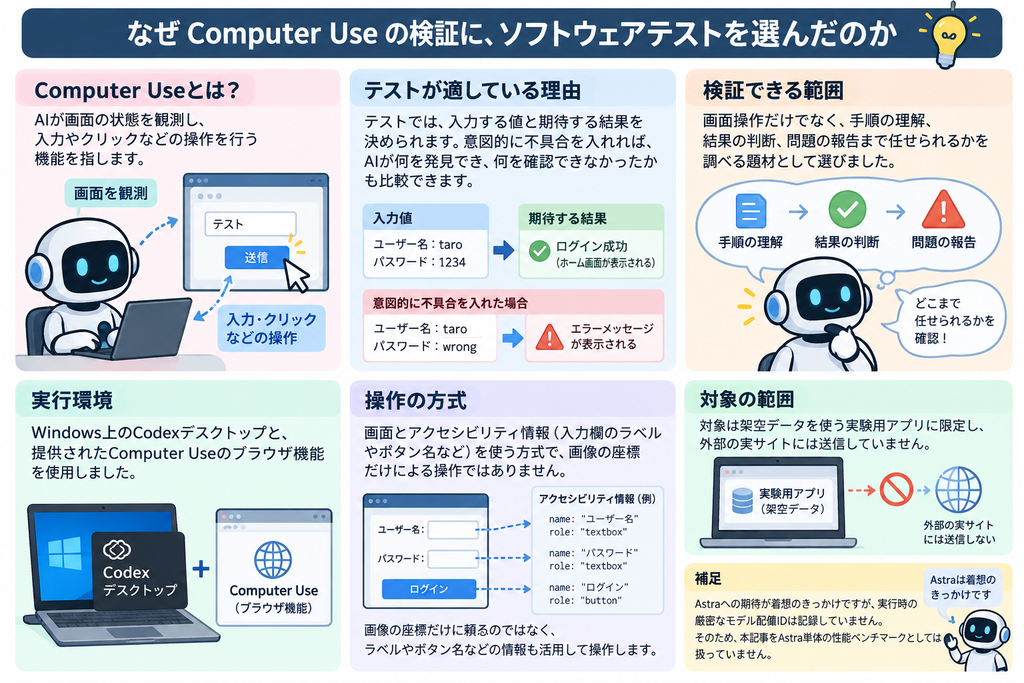
この記事でいうComputer Useは、AIが画面の状態を見て、入力やクリックなどの操作を自分で行う機能を指します。
テストを題材に選んだのには理由があります。テストは、入力する値と期待する結果をあらかじめ決められます。意図的に不具合を仕込んでおけば、AIが何を発見でき、何を確認できなかったかを、はっきり比較できます。しかもテストには、画面操作だけでなく、手順の理解・結果の判断・問題の報告まで含まれます。「どこまで任せられるか」を調べる題材として、うってつけでした。
実行にはWindows上のCodexデスクトップと、提供されたComputer Useのブラウザ機能を使用しました。画面とアクセシビリティ情報(入力欄のラベルやボタン名など)を使う方式で、画像の座標だけによる操作ではありません。通常のChatGPTチャット内で動作を想像させたものでもなく、起動したローカルアプリを実際に操作しています。
対象は架空データを使う実験用アプリに限定し、外部の実サイトには送信していません。なお、Astraへの期待が着想のきっかけですが、実行時の厳密なモデル配備IDは記録していません。そのため、本記事をAstra単体の性能ベンチマークとしては扱っていません。
大量のケースを渡し、何度も実行してもらえるか
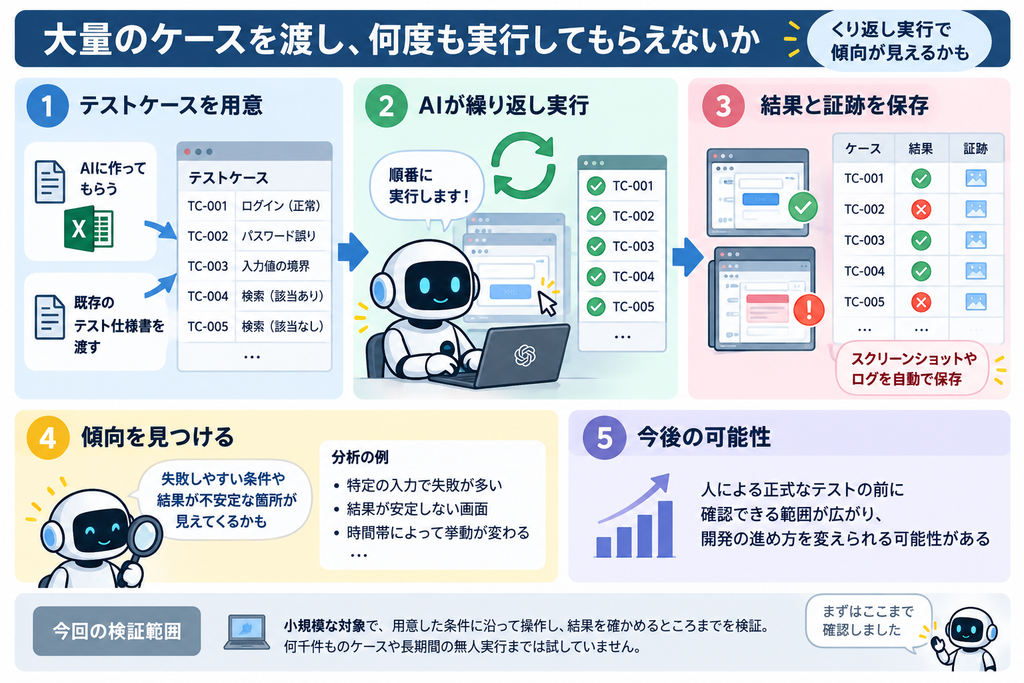
一次テストを任せる構想には、「何度でも繰り返せる」ことへの期待もありました。
多くのテストケースを用意してAIに実行してもらい、結果と証跡(=操作した画面のスクリーンショットや記録)を残します。それを繰り返せば、失敗しやすい条件や、結果が安定しない箇所などの傾向が見えてくるかもしれません。
ケース自体をAIに作ってもらう方法もあれば、人がこれまで使ってきたテスト仕様書を渡す方法もあります。どちらの場合も、人による正式なテストの前に確認できる範囲が広がれば、開発の進め方を変えられる可能性があります。
ただし、今回試したのは小規模な対象です。何千件ものケースや長期間の無人実行まで検証したわけではありません。まずは、用意した条件に沿って操作し、結果を確かめるところまで成立するかを調べました。
実際に動かしました
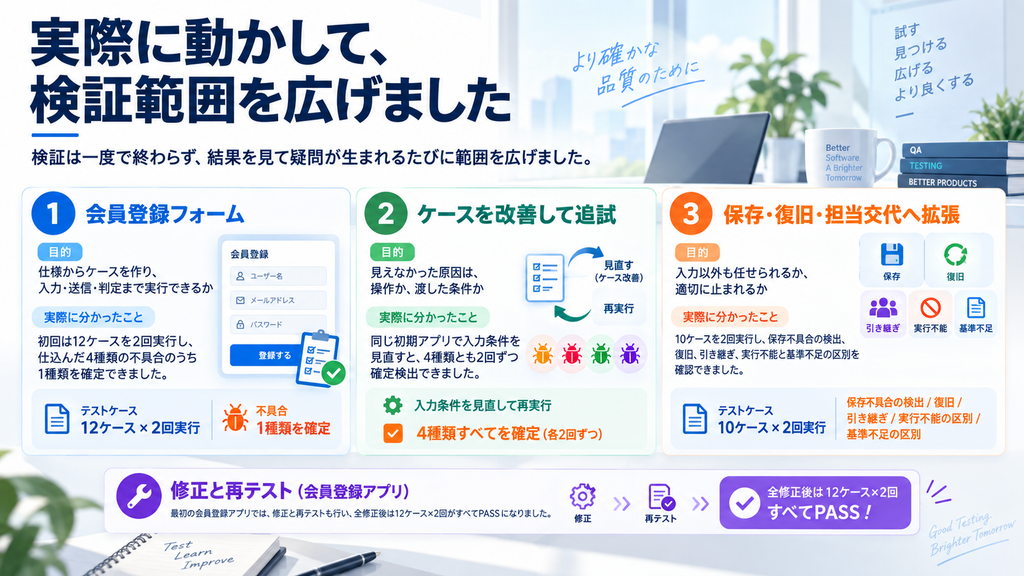
検証は一度で終わりませんでした。結果を見るたびに新しい疑問が生まれ、そのつど範囲を広げていったからです。今回は目的の違う3つの段階を、少しずつ広げていきました。全体像は次のとおりです。
| 段階 | 確かめたかったこと | 実際に分かったこと |
|---|---|---|
| 会員登録フォーム | 仕様からケースを作り、入力・送信・判定まで実行できるか | 初回は12ケースを2回実行し、仕込んだ4種類の不具合のうち1種類を確定できました |
| ケースを改善して追試 | 見えなかった原因は、操作か、渡した条件か | 同じ初期アプリで入力条件を見直すと、4種類とも2回ずつ確定検出できました |
| 保存・復旧・担当交代へ拡張 | 入力以外も任せられるか、適切に止まれるか | 10ケースを2回実行し、保存不具合の検出、復旧、引き継ぎ、実行不能と基準不足の区別を確認できました |
それぞれ目的と条件が異なるため、結果を一つの成功率にはまとめていません。最初の会員登録アプリでは修正と再テストも行い、全修正後は12ケース×2回がすべてPASSになりました。
同じ結果を繰り返しても、見えない不具合がありました
最初のフォームには、「18歳を誤って登録拒否してしまう」不具合を仕込んでいました。ここに落とし穴がありました。氏名やメールなど「別の項目」を調べるケースでも、入力する年齢に18歳を使っていたのです。すると、氏名やメールに問題があっても、その手前で年齢エラーに引っかかり、登録が止まってしまいます。
「不正な入力を拒否したら合格」という基準では、これらはPASSになります。しかし、それだけでは、本当に調べたかった項目が正しくチェックされたとは言えません。
担当はほかの不具合の可能性にも言及しましたが、初回に確定できたのは4種類中1種類でした。そこで追試として、年齢以外を調べるケースの年齢を25歳に変更したところ、隠れていた不具合も確定できました。ただし、追試の改善担当は前の結果を知っているため、未知の不具合を常に発見できるという実証ではありません。
ここで分かったのは、AIが指示どおりに操作できても、渡す条件によって得られる情報は変わるということです。反復する回数だけでなく、「何を確かめるケースなのか」を見直す必要があると分かりました。
「保存しました」の先まで確認できました
次の実験では、会員情報を保存・編集するアプリを用意しました。追加した会員は一覧にも表示され、画面には「保存しました」と出ます。ところが、再読み込みすると、その会員が消える――そんな条件をわざと仕込みました。
AIは成功表示だけで終えず、手順に含めた再読み込みまで実行し、不具合として報告しました。編集した値が元に戻る不具合や、別の会員のメモまで変わる不具合も、2回とも検出できました。
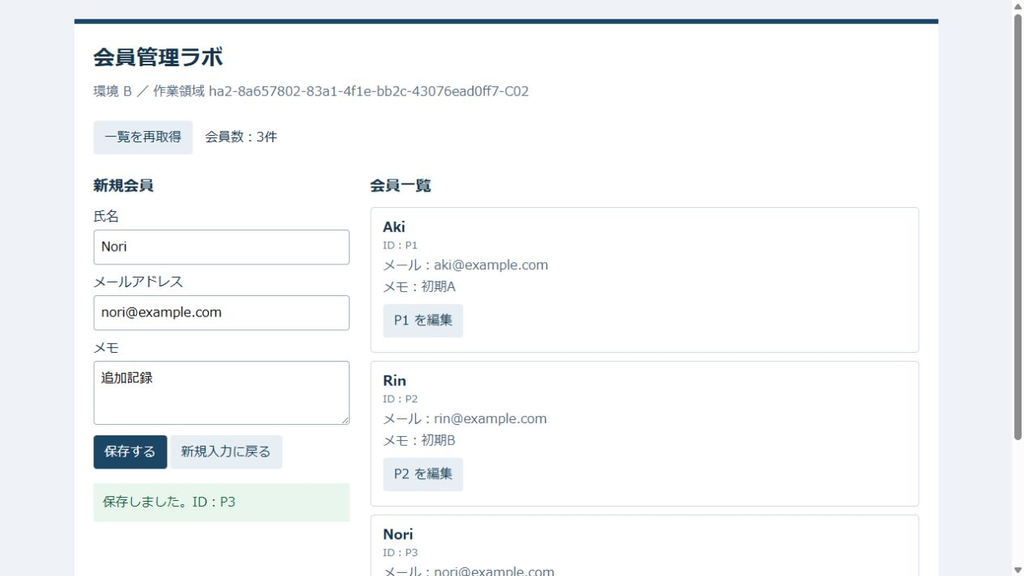
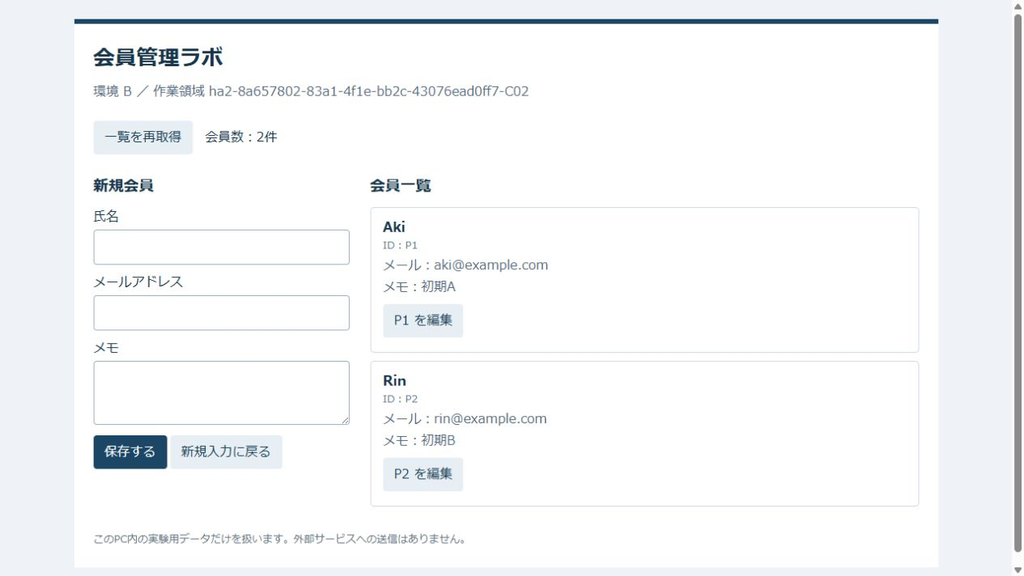
この拡張実験は10ケース×2回で、合格10件、不具合を検出したケース6件、実行不能2件、基準不足による保留2件でした。不具合は3種類を2回ずつ検出したものです。事前の正解表との照合で誤合格は0件で、保存状態を確認できる18件はサーバー記録とも整合しました。これらは拡張実験の結果で、最初のフォーム実験と混ぜていません。
10ケースのうち8ケースは、同じ追加・編集手順を異なる環境条件で試しています。主担当は2回共通で、担当交代の後半だけは各回別の新規担当が実行しました。幅広い実システムや、独立したチームによる追試ではありません。
途中で問題が起きたとき、どこまで進められるか
順調なときに操作できるだけでなく、失敗したあとに適切に対応できるかも確かめました。
「最初の保存だけ失敗する」条件では、再試行してきちんと完了できました。「保存は済んでいるのに、応答だけが失敗に見える」やっかいな条件では、一覧を再取得し、保存済みだと確かめてから先へ進みました。両回とも追加をやり直さず、重複を生みませんでした。
担当交代の実験では、登録済みのID、完了した処理、残りの手順をファイルに残しました。新しいAI担当はその記録から再開し、登録を繰り返さず対象の行だけを編集できました。
一方、保存が失敗し続けるケースは、再試行の上限で止めて実行不能としました。「初心者が迷わず使いやすい」という要求には、合否の判断基準が足りないとして保留を残しました。基準不足では保留するよう事前に指示しているため、AIが自発的にあらゆる限界を見極めたという意味ではありません。
今回、「ここから先は人間にしかできない」という画面操作の境界そのものは、特定できませんでした。
AIの一次テストを、人の正式なテストにつなげるには
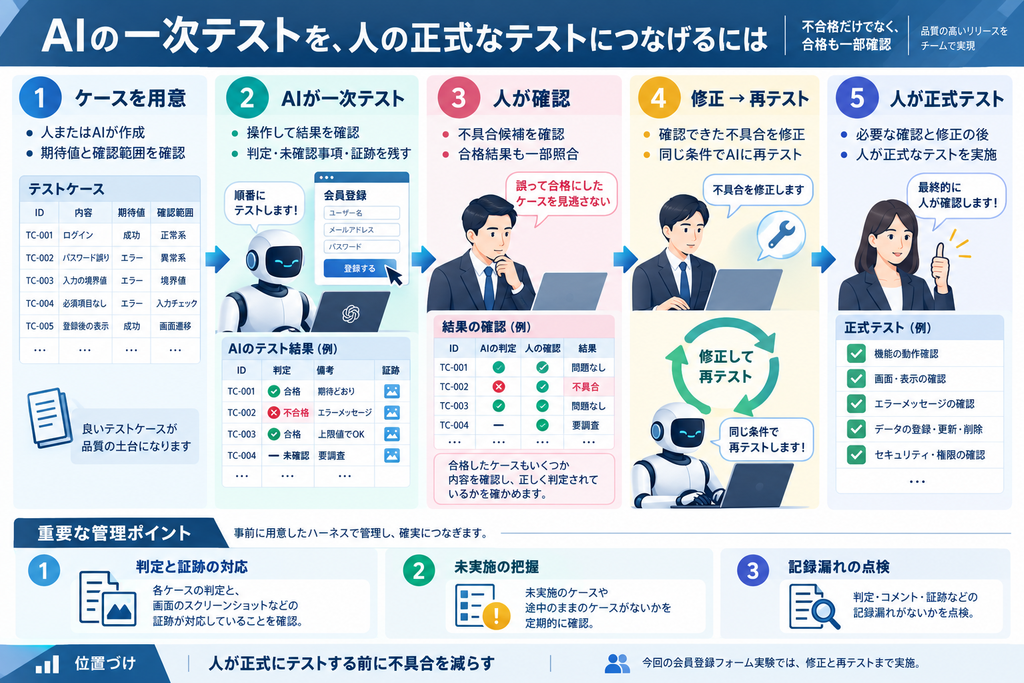
当初の構想では、AIが報告した怪しい動きやバグを人が確認し、修正してから再テストする流れを考えていました。今回の体験からは、その流れに、AIが合格とした結果も一部確認する工程を加えたいと考えています。
不合格だけを確認すると、間違って合格にしたケースを見逃す可能性があります。最初のフォーム実験のように、同じ判定が2回続いても、条件の作り方によって不具合が隠れることがあります。
結果を人の確認につなげるには、判定と証跡の対応、未実施、記録漏れを点検できることが重要です。今回の検証では、これらを管理するハーネス(=テストの進行と記録をまとめて管理する仕組み。採点表と記録係を兼ねたもの)を事前に用意した条件で、AIによる操作と判断を評価しました。
現時点で想定している流れは、次のとおりです。検証結果を踏まえた運用案であり、この全体による品質向上や工数削減はまだ測定していません。
- 人またはAIがケースを用意し、期待値と確認範囲を確認します。
- AIが一次テストを実行し、判定・未確認事項・証跡を残します。
- 人が不具合候補を確認するとともに、合格結果も一部照合します。
- 確認できた不具合を修正し、同じ条件でAIに再テストしてもらいます。
- 必要な確認と修正を繰り返したあと、人が正式なテストを実施します。
位置づけは「人が正式テストに入る前に、不具合を減らしておく」こと。今回の会員登録フォームの実験では、この不具合の修正と再テストまで実施しました。
画面や指示を変え、任せられる条件を広げて確かめました
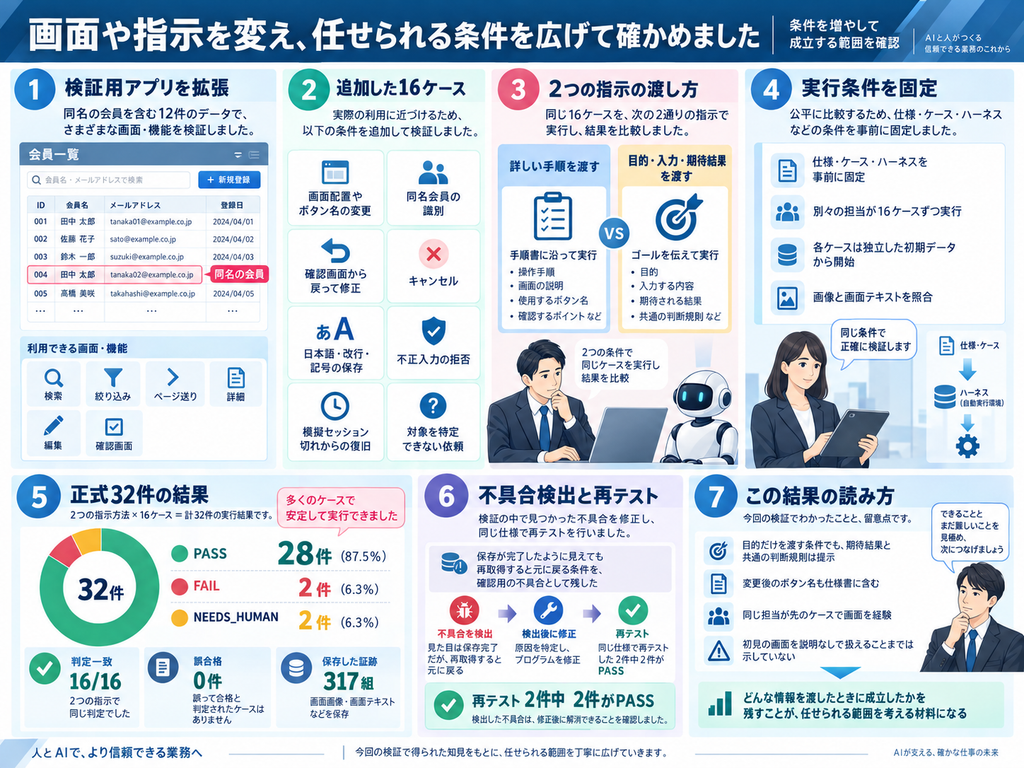
ケース数を増やすなら、同じ入力を繰り返すだけでなく、まだ試していない条件を増やしたいと考えました。そこで、同名の会員を含む12件のデータと、検索・絞り込み・ページ送り・詳細・編集・確認画面を備えたアプリを用意しました。
追加したのは16ケースです。画面の配置やボタン名の変更、同名会員の識別、確認画面から戻っての修正、キャンセル、日本語・改行・記号の保存、不正入力の拒否、模擬セッション切れからの復旧、対象を特定できない依頼を含めました。さらに、詳しい手順を渡す場合と、目的・入力・期待結果だけを渡す場合も設けています。
仕様・ケース・ハーネスの条件を事前に固定し、別々の担当が16ケースずつ実行しました。各ケースは独立した初期データから開始し、判定の根拠となる画像と画面テキストを照合しています。
正式32件の結果は、PASS 28件、FAIL 2件、NEEDS_HUMAN(人の確認が必要)2件でした。両担当の判定が一致したのは16/16ケースで、誤って合格にしたケースは0件でした。317組の画面・テキスト証跡を保存しています。
保存が完了したように見えても再取得すると元に戻る条件は、不具合検出の確認用に残しました。検出後に修正し、同じ仕様で再テストした2件のうち2件がPASSとなりました。
この追加検証では、目的だけを渡す条件でも、期待結果と共通の判断規則は示しています。変更後のボタン名も仕様書に含め、同じ担当が先のケースで画面を経験しています。したがって、初見の画面を説明なしで扱えるという意味には広げません。実際にどんな情報を渡したときに成立したかを残すことが、開発で任せられる範囲を考える材料になると考えています。
エンジニアが追試する際に、用意したい情報
AIに一次テストを任せるうえで肝になるのは、実行と記録を管理するハーネスを事前に整えておくことです。操作対象と入力値の固定、開始・終了時刻の自動記録、ケースと証跡の対応付け、未確認の項目がある場合の合格禁止、再試行や停止の条件まで用意します。実行前にこれらが機能することを確認しておくと、アプリの不具合と実行環境の問題を区別でき、人が結果を確認しやすくなります。
今回の実行担当には、操作手順に加え、入力値、期待する状態、確認方法、再試行上限、記録する内容を渡しました。ケースを作る担当とは会話コンテキストを分け、ソースコードや不具合一覧は読ませていません。アクセス権を物理的に遮断した分離ではなく、指示とコンテキストによる分離です。
最初のフォーム実験では、別担当が仕様からケースを作りました。ケース改善の追試と拡張実験では、作成担当が検証内容を設計しました。AIにケースを作らせたこともありますが、網羅性まで保証できたわけではありません。
実行と確認の土台になったのは、次の情報です。
- 完了条件:何が確認できたら終わりなのかを決めます。成功表示に加え、保存された値や件数も確認します。
- 途中の判断:失敗したとき何を再確認し、どこまで再試行するかを決めます。
- 引き継ぎ情報:完了した処理、対象のID、残りの手順を残します。
- 報告の根拠:判定に対応する画面や記録を保存し、未確認の項目を区別します。
なお、「待って再確認する」動きはComputer Useだけの能力ではありません。Playwright Testにも、制限時間内で期待する状態を繰り返し確認する機能があります。今回は既存の自動テストとの優劣を測っておらず、置き換えるべきだという結論は出していません。
開発のどこまでを任せられるか、線引きの出発点
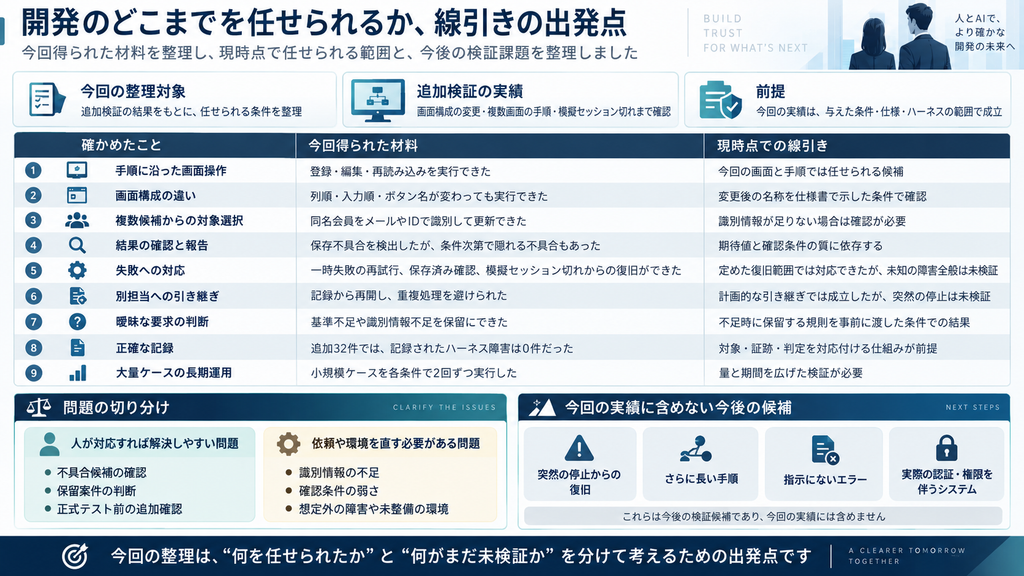
今回得られた材料を整理すると、次のようになります。
| 確かめたこと | 今回得られた材料 | 現時点での線引き |
|---|---|---|
| 手順に沿った画面操作 | 登録・編集・再読み込みを実行できました | 今回の画面と手順では任せられる候補です |
| 画面構成の違い | 列順・入力順・ボタン名が変わっても実行できました | 変更後の名称を仕様書で示した条件で確認しています |
| 複数候補からの対象選択 | 同名の会員をメールやIDで識別して更新できました | 識別情報が足りない場合は確認が必要です |
| 結果の確認と報告 | 保存不具合を検出しましたが、最初の条件では隠れた不具合もありました | 期待値と確認条件の質に依存します |
| 失敗への対応 | 一時失敗の再試行、保存済みの確認、模擬セッション切れからの復旧ができました | 定めた復旧範囲では対応できましたが、未知の障害全般は未検証です |
| 別担当への引き継ぎ | 記録から再開し、重複処理を避けました | 計画的な引き継ぎでは成立しましたが、突然の停止は未検証です |
| 曖昧な要求の判断 | 使いやすさの基準不足や、更新対象の識別情報不足を保留にしました | 不足時に保留する規則を事前に渡した条件での結果です |
| 正確な記録 | 事前に整備したハーネスで実行した追加32件では、記録されたハーネス障害は0件でした | 対象・証跡・判定を対応付ける仕組みが前提です |
| 大量ケースの長期運用 | 小規模なケースを各条件で2回ずつ実行しました | 量と期間を広げた検証が必要です |
同じ「解決すべき問題」でも、人が対応すれば済むものと、依頼の出し方や環境そのものを直す必要があるものは、分けて考えたいと思います。
追加検証では画面構成の変更と、複数画面にまたがる手順、模擬セッション切れまで範囲を広げました。今後の候補は、突然の停止からの復旧、さらに長い手順、指示にないエラー、実際の認証・権限を伴うシステムです。これらは今回の実績には含めません。
コードの確認から、実際の操作と結果確認へ
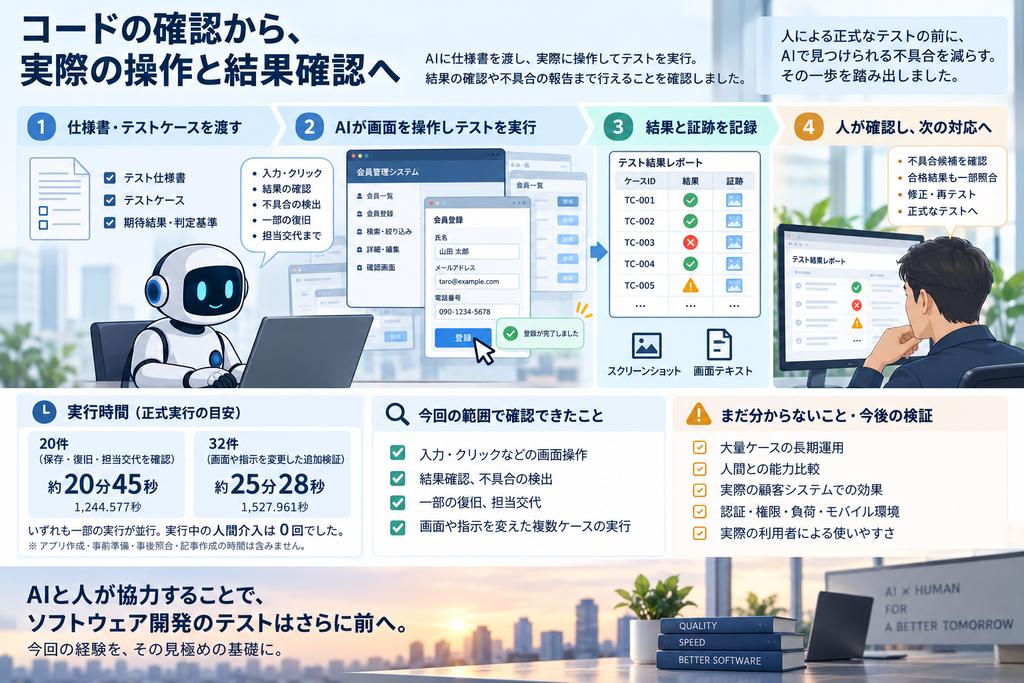
今回の条件では、Computer Useを使ってAIにテストを実行させることができました。入力・クリックだけでなく、結果の確認、不具合の報告、一部の復旧、担当交代まで、実際に行えました。
かかった時間も記しておきます。保存・復旧・担当交代を確認した20件の正式実行は、開始から終了まで1,244.577秒、約20分45秒でした。画面や指示を変えた追加32件は1,527.961秒、約25分28秒でした。いずれも一部の実行が並行しており、アプリ作成・事前準備・事後照合・記事作成の時間は含みません。両実験の正式実行中に記録された人間介入は0回でした。親エージェント(全体の進行を管理する上位のAI)による進行調整と事後照合は行っています。
一方で、大量ケースの長期運用、人間との能力比較、実際の顧客システムでの効果はまだ分かりません。認証、権限、負荷、モバイル、実際の利用者による使いやすさも対象外です。
それでも、これまでの「AIにコードを見てもらう」という使い方から、「仕様書を渡し、実際に操作して結果を確認してもらう」という使い方へ、一歩踏み出せました。
人による正式なテストの前に、AIがどこまで不具合を見つけられるのか。人が確認しやすい形で、結果を残せるのか。今回の経験を、その見極めの基礎にしたいと考えています。こうした検証を重ねることで、ソフトウェア開発におけるテストの自動化・AI活用は、さらに広がっていくのではないでしょうか。
実施日は2026年9月13〜14日(日本時間)です。実測数値は各実験の記録に基づきます。事後照合は作成担当が行っており、第三者監査や多数の独立試行による性能評価ではありません。
▼ アクロビジョンについて
